Pestaña Estadísticas
 Lo que te está costando
el modelo de lenguaje, en tokens y en latencia.
Un token es la unidad básica de cómputo de un modelo de lenguaje: aproximadamente una palabra o un número. Si usas un proveedor de nube de pago, los tokens son el contador.
Telemetría del LLM
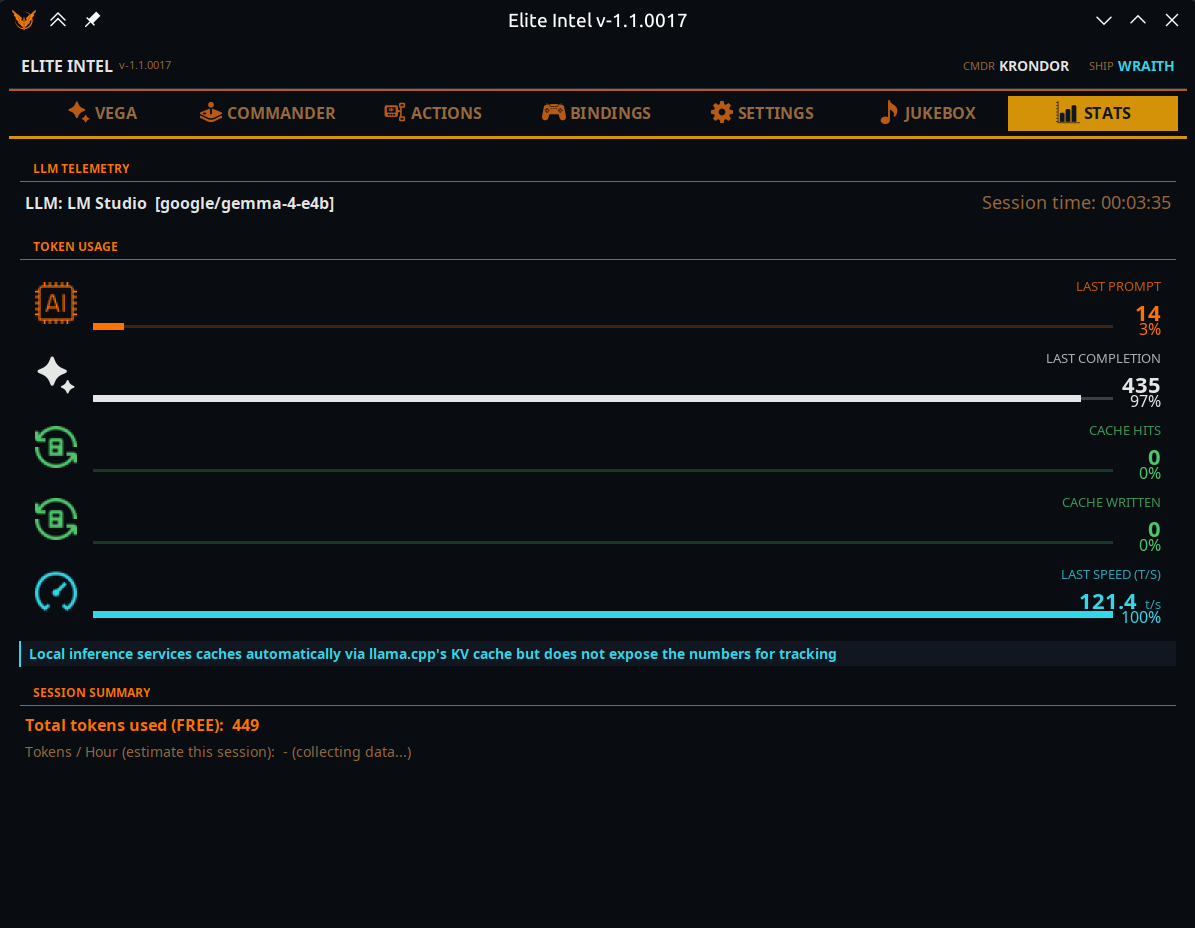
El modelo que atiende realmente tus peticiones y cuánto lleva corriendo esta sesión. El nombre del modelo es el que respondió, no el que configuraste, así que aquí es donde confirmas que tu cambio de proveedor surtió efecto de verdad.
Uso de tokens
Cinco barras. Describen la petición más reciente, no la sesión, para que veas la forma de un único intercambio.
| Celda | Significado |
|---|---|
| Último prompt | Tokens de entrada enviados |
| Última respuesta | Tokens de salida generados |
| Aciertos de caché | Entrada servida desde caché en lugar de volver a facturarse |
| Escrito en caché | Entrada escrita en la caché para que peticiones posteriores acierten |
| Última velocidad | Tokens por segundo |
Las cuatro barras de tokens se llenan como proporción del total de esa única petición, de modo que se leen como una composición. La velocidad no tiene techo fijo, así que su barra se llena en relación con la respuesta más rápida vista en esta sesión.
Resumen de la sesión
| Línea | Significado |
|---|---|
| Tokens usados | Marcado (GRATIS) con un modelo local y (facturable) con uno en la nube |
| Tokens ahorrados por caché | Solo nube. Indica "servido a tarifa reducida" en cuanto hay aciertos |
| Tokens / hora | Una proyección. Muestra "recopilando datos…" durante los primeros 10 minutos, porque una tasa extrapolada de dos minutos de juego es una ficción |
Qué significan las cifras en la práctica
Una sesión típica ronda los 250 000 tokens por hora en total.
La integración con la nube de Elite Intel está ajustada por proveedor para maximizar el caché de prompts, y los tokens en caché son gratuitos o se facturan a tarifa reducida. Cuánto de esos 250 000 acaba en caché depende por completo del proveedor: algunos cachean hasta el 80 %, otros más bien el 40 %. Esa diferencia es lo principal que separa a un proveedor barato de uno caro, y vale la pena observarlo aquí durante una sesión antes de comprometerte.
Con un modelo local no hay cifras de caché. La inferencia local sí cachea —llama.cpp mantiene una caché KV y la usa— pero no informa de los números, así que no hay nada honesto que mostrar. El panel lo dice en lugar de mostrar un cero engañoso, y oculta por completo la línea de caché.
Para una versión en vivo y de un vistazo de estos mismos datos, la pestaña Vega lleva abajo una franja Resumen del sistema de seis bloques.
Community 👉Matrix👈