Reiter „Statistik"
 Was dich das Sprachmodell
kostet — in Tokens und in Latenz.
Ein Token ist die Grundeinheit der Sprachmodell-Rechenleistung — ungefähr ein Wort oder eine Zahl. Bei einem kostenpflichtigen Cloud-Anbieter sind Tokens der Zähler.
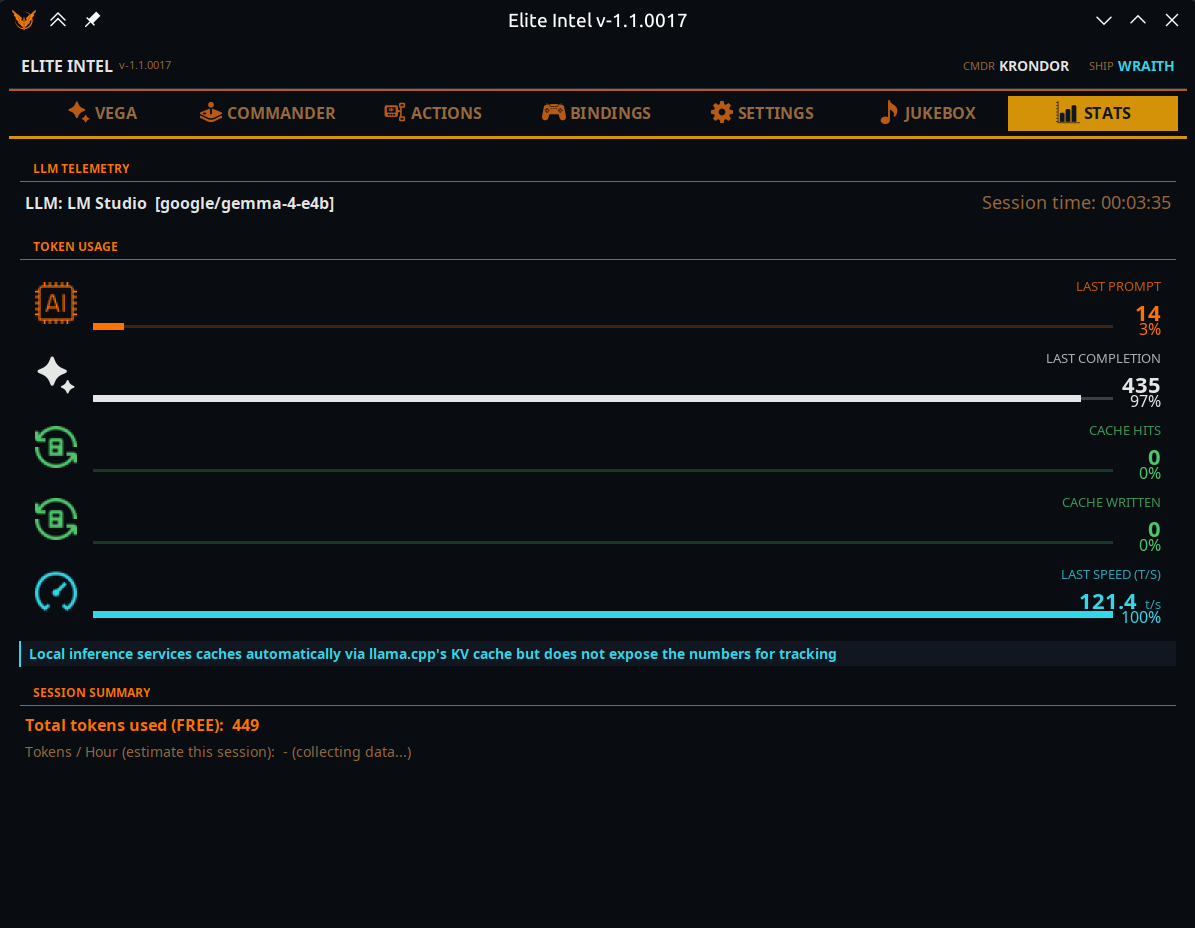
LLM-Telemetrie
Das Modell, das deine Anfragen tatsächlich bedient, und wie lange diese Sitzung schon läuft. Der Modellname ist das, was geantwortet hat — nicht das, was du konfiguriert hast. Hier bestätigst du also, dass dein Anbieterwechsel wirklich gegriffen hat.
Token-Verbrauch
Fünf Balken. Sie beschreiben die letzte Anfrage, nicht die Sitzung, damit du die Form eines einzelnen Austauschs erkennst.
| Feld | Bedeutung |
|---|---|
| Letzter Prompt | Gesendete Eingabe-Tokens |
| Letzte Antwort | Erzeugte Ausgabe-Tokens |
| Cache-Treffer | Eingabe aus dem Cache bedient, statt erneut berechnet zu werden |
| Cache geschrieben | Eingabe, die in den Cache geschrieben wurde, damit spätere Anfragen darauf treffen |
| Letzte Geschwindigkeit | Tokens pro Sekunde |
Die vier Token-Balken füllen sich als Anteil an der Gesamtsumme dieser einen Anfrage und lassen sich daher als Zusammensetzung lesen. Geschwindigkeit hat keine feste Obergrenze, ihr Balken füllt sich deshalb relativ zur schnellsten Antwort dieser Sitzung.
Sitzungsübersicht
| Zeile | Bedeutung |
|---|---|
| Tokens verwendet | Bei einem lokalen Modell mit (KOSTENLOS) gekennzeichnet, bei einem Cloud-Modell mit (kostenpflichtig) |
| Durch Caching gespart | Nur Cloud. Sobald es Treffer gibt, steht dort „zu reduziertem Tarif abgerechnet" |
| Tokens / Stunde | Eine Hochrechnung. In den ersten 10 Minuten steht dort „Daten werden gesammelt…", weil eine aus zwei Minuten Spielzeit hochgerechnete Rate eine Fiktion wäre |
Was die Zahlen praktisch bedeuten
Eine typische Sitzung liegt insgesamt bei etwa 250.000 Tokens pro Stunde.
Die Cloud-Anbindung von Elite Intel ist pro Anbieter auf maximales Prompt-Caching abgestimmt, und zwischengespeicherte Tokens sind entweder kostenlos oder werden zu reduziertem Tarif abgerechnet. Wie viel dieser 250.000 im Cache landet, hängt ganz vom Anbieter ab — manche cachen bis zu 80 %, andere eher 40 %. Genau dieser Unterschied trennt einen günstigen von einem teuren Anbieter, und es lohnt sich, das hier eine Sitzung lang zu beobachten, bevor du dich festlegst.
Bei einem lokalen Modell gibt es keine Cache-Zahlen. Lokale Inferenz cacht durchaus — llama.cpp führt einen KV-Cache und nutzt ihn — meldet die Zahlen aber nicht, sodass es nichts Ehrliches zu zeigen gibt. Das Panel sagt das, statt eine irreführende Null anzuzeigen, und blendet die Cache-Zeile ganz aus.
Für eine Live-Kurzfassung derselben Daten trägt der Vega-Reiter unten eine Systemzusammenfassung aus sechs Blöcken.
Community 👉Matrix👈