LLM auswählen
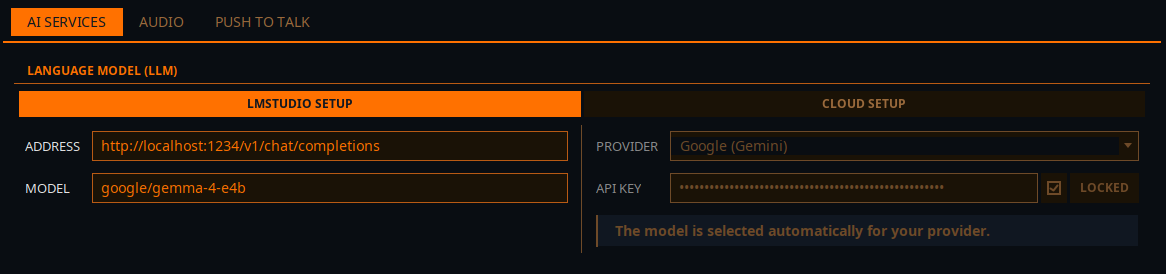
Elite Intel braucht ein Sprachmodell (LLM), um deine Befehle zu verstehen und deine Fragen zu beantworten. Es gibt zwei Wege dorthin, und beide richtest du unter Einstellungen → KI-Dienste → Sprachmodell (LLM) ein:
| Option | Was du brauchst | Kosten |
|---|---|---|
| Lokal: LM Studio | Eine leistungsfähige GPU, LM Studio und das Modell google/gemma-4-e4b |
Kostenlos. Alles bleibt auf deinem PC |
| Cloud | Ein Konto und einen API-Schlüssel bei einem unterstützten Anbieter | Der Anbieter berechnet dir deine Nutzung |
Option 1: Lokal (LM Studio)
Die linke Seite des Bereichs, LMSTudio:
| Feld | Wert |
|---|---|
| Adresse | http://localhost:1234/v1/chat/completions. Läuft LM Studio auf einem anderen PC in deinem Netzwerk, ersetze localhost durch dessen IP-Adresse |
| Modell | google/gemma-4-e4b |
LM Studio ist der einzige lokale Inferenzserver, den Elite Intel unterstützt, und
google/gemma-4-e4b das einzige unterstützte lokale Modell.
GPU-Anforderungen
Diese Hardware brauchst du, um Spiel und LLM auf demselben Rechner zu betreiben:
- RTX 3090 24 GB VRAM
- AMD RX 7800 XT
Der VRAM zählt mehr als die GPU-Geschwindigkeit. Eine Karte mit nur 12 GB VRAM reicht nicht, egal wie neu sie ist. Hast du einen zweiten PC mit einer leistungsfähigen GPU, lass LM Studio dort laufen und richte Elite Intel darauf aus. Dann leistet der Spiele-PC keine Inferenzarbeit.
Eine GPU-Referenztabelle von Kevin Rank findest du hier: GPU-Referenzleitfaden
Installationsanleitungen
| Anleitung | |
|---|---|
| LM Studio – Linux | Desktop-Installation und Betrieb als Server |
| LM Studio – Windows | Desktop-App mit GUI |
| LLMs auf der AMD-RX-Serie | AMD-spezifische Einrichtung |
| LM Studio auf Ubuntu Server | Headless-Installation auf einem eigenen Inferenzrechner |
Warum gerade google/gemma-4-e4b?
Elite Intel ist ein Befehlsparser und ein Werkzeug zur Datenanalyse, kein Chatbot für Plaudereien. Natürlich klingendes Geplänkel reicht nicht. Das Modell muss aus deinen Worten die richtige Aktion ableiten, Spieldaten analysieren und strukturierte Ergebnisse liefern statt eines Aufsatzes oder HTML. Nicht jedes Modell dieser Größe schafft das zuverlässig.
Die harte Anforderung ist Function Calling. Der Companion von Elite Intel bittet das Modell
nicht, zu beschreiben, was es tun würde. Er gibt ihm eine Reihe von Werkzeugen und erwartet, dass
es eines davon mit Argumenten aufruft. Ein Modell, das keinen sauberen Werkzeugaufruf erzeugen
kann, kann die App überhaupt nicht steuern, egal wie gut es schreibt. google/gemma-4-e4b
unterstützt Function Calling.
Mit rund 6,3 GB passt es auf einer 24-GB-Karte mit reichlich Reserve neben dem Spiel in den VRAM. Nichts wird auf die CPU ausgelagert, also bleiben die Antworten schnell.
Zum ausgemusterten V1.0-Modell. Frühere Versionen empfahlen
tulu-3.1-8b-supernova. Es unterstützt kein Function Calling, kann den Companion also nicht betreiben und funktioniert nicht mehr mit Elite Intel. Folgst du einer älteren Anleitung, ignoriere sie und installieregoogle/gemma-4-e4b.
Option 2: Cloud
Die rechte Seite des Bereichs, Cloud-Einrichtung:
- Wähle deinen Anbieter in der Liste Anbieter.
- Füge den Schlüssel dieses Anbieters in API-Schlüssel ein.
- Setze den Haken bei Gesperrt, damit der gespeicherte Schlüssel nicht versehentlich geändert wird.
- Drücke Speichern und starte dann die Dienste im Reiter Vega (neu).
Den Anbieter wählst du selbst. Elite Intel versucht nicht, ihn am Schlüssel zu erkennen, denn die Anbieter ändern ihre Schlüsselformate zu oft, als dass das zuverlässig wäre. Ein Modell wählst du nicht: Elite Intel nimmt das passende für deinen Anbieter.
| Anbieter | Hinweise |
|---|---|
| Anthropic (Claude) | Kostenpflichtig |
| OpenAI | Kostenpflichtig |
| Google (Gemini) | Kostenpflichtig |
| xAI (Grok) | Kostenpflichtig |
| DeepSeek | Kostenpflichtig |
Wie du bei jedem Anbieter einen Schlüssel bekommst: Cloud-LLM einrichten.
Was soll ich nehmen?
Nimm LM Studio lokal, wenn:
- du eine RTX 3090 24 GB oder Gleichwertiges hast, oder einen zweiten PC im Netzwerk mit einer solchen Karte
- alles auf deiner eigenen Hardware bleiben soll
Nimm einen Cloud-Anbieter, wenn:
- deine GPU nicht genug VRAM hat, um ein Modell neben dem Spiel zu betreiben
- du überhaupt keinen Inferenzserver betreiben willst
Unsicher? Du kannst mit beidem anfangen und jederzeit ohne Neuinstallation wechseln.
Community 👉Matrix👈