Вибір локального сервера інференції
Для запуску локального LLM з Elite Intel потрібен сервер інференції. Це програмне забезпечення, яке завантажує модель ШІ та надає до неї доступ через локальний API. Це локальний еквівалент хмарного сервісу ШІ, що працює повністю на твоєму власному залізі.
Elite Intel використовує LM Studio як сервер інференції. Він працює у Windows і Linux та надає OpenAI-сумісний API.
Вимоги до GPU
Вимоги до заліза для запуску гри та LLM на одній машині:
- RTX 3090 24 ГБ VRAM
- AMD RX 7800 XT
Якщо у тебе недостатньо заліза, скористайся безкоштовним хмарним сервісом на 👉 console.mistral.ai 👈 — безкоштовний рівень, без кредитної картки. Кроки налаштування: Безкоштовний хмарний LLM.
Таблиця порівняння GPU від Kevin Rank доступна тут: Довідник з GPU
Посібники з встановлення
| Сервер інференції | |
|---|---|
| ✅ LM Studio - Linux | Швидкий, більша гнучкість моделей - посібник показує налаштування як сервера |
| ✅ LM Studio - Windows | Швидкий, більша гнучкість моделей - є графічний інтерфейс |
| 🆓 Безкоштовний хмарний LLM | GPU не потрібен - безкоштовний рівень Mistral, без кредитної картки |
LM Studio: коротко
| LM Studio | |
|---|---|
| Потрібна модель | google/gemma-4-e4b |
| Встановлення | Один скрипт, і готово |
| Запускається як | Ручний запуск або опційний автозапуск |
| Налаштування моделі | Прапорці під час завантаження |
| Автозапуск у Windows | Потрібен застосунок або Планувальник завдань |
| Автозапуск у Linux | Ручне налаштування systemd (див. посібник для Linux) |
| Джерело моделей | HuggingFace (GGUF) |
| Порт API | 1234 |
| Графічний інтерфейс | Опційний застосунок для робочого столу |
Посібник з вибору
Запускай LM Studio локально, якщо:
- У тебе є NVIDIA RTX 3090 24 ГБ або аналог чи краще. VRAM - критичний фактор, а не швидкість GPU. GPU лише з 12 ГБ VRAM є недостатнім незалежно від покоління.
- Ти запускаєш Elite Dangerous та LLM на одній машині
- Хочеш вказати Elite Intel на окремий ПК у своїй мережі
- Тобі потрібен графічний інтерфейс для перегляду, завантаження та управління моделями або чистий headless-сервер на виділеній машині
Краще скористайся безкоштовним хмарним LLM, якщо:
- Твоїй відеокарті бракує VRAM, щоб тримати модель разом із грою
- Ти взагалі не хочеш обслуговувати локальний сервер інференції
Рекомендація розробника
Розробник використовує LM Studio з google/gemma-4-e4b (~6,3 ГБ). Інші моделі можуть працювати,
але це не гарантовано. Повідомляйте про результати сумісності в Matrix.
Чому саме google/gemma-4-e4b?
Elite Intel — це парсер команд та інструмент аналізу даних, а не розмовний чат-бот. Це висуває до моделі конкретні вимоги. Уміння вести природну бесіду недостатньо. Модель має правильно виводити дії з голосового введення, виконувати структурований аналіз даних і повертати результати у вигляді структурованих даних, а не есе в markdown чи HTML. Не всі моделі такого розміру роблять це надійно.
Жорстка вимога — виклик функцій (function calling). Компаньйон Elite Intel не просить модель
описати, що вона зробила б: він пропонує їй набір інструментів і очікує виклику одного з них з
аргументами. Модель, яка не вміє формувати коректний виклик інструмента, взагалі не зможе керувати
застосунком, хоч би як добре вона писала. google/gemma-4-e4b це підтримує.
За обсягу близько 6,3 ГБ вона вміщується у VRAM поряд із грою на карті з 24 ГБ із запасом, що виключає вивантаження на CPU і зберігає високу швидкість інференсу.
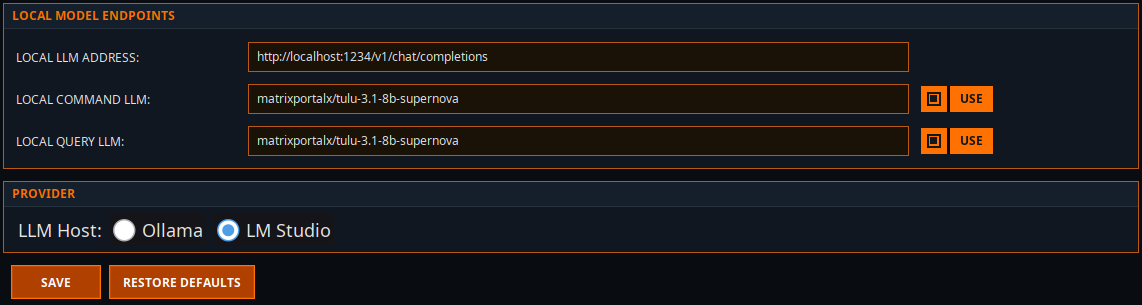
Про зняту з підтримки модель V1.0. Ранні версії рекомендували
tulu-3.1-8b-supernova. Вона не підтримує виклик функцій, тому не може працювати з компаньйоном і більше не придатна для Elite Intel. Якщо ви користуєтесь старим посібником, не використовуйте його та встановітьgoogle/gemma-4-e4b.
Чи можу я використовувати іншу модель?
Можна використовувати альтернативні моделі, але вони мають підтримувати виклик функцій. Без цього застосунок не зможе нічого виконати.
Найчастіший збій з альтернативною моделлю — неправильний формат відповіді: модель повертає текст з описом дії замість фактичного виклику інструмента.
Community 👉Matrix👈