Elegir tu LLM
Elite Intel necesita un modelo de lenguaje (LLM) para entender tus órdenes y responder a tus preguntas. Hay dos formas de conseguirlo, y las dos se configuran en Ajustes → Servicios de IA → Modelo de lenguaje (LLM):
| Opción | Qué necesitas | Coste |
|---|---|---|
| Local: LM Studio | Una GPU potente, LM Studio y el modelo google/gemma-4-e4b |
Gratis. Todo se queda en tu PC |
| Nube | Una cuenta y una clave API de un proveedor compatible | El proveedor te cobra lo que uses |
Opción 1: Local (LM Studio)
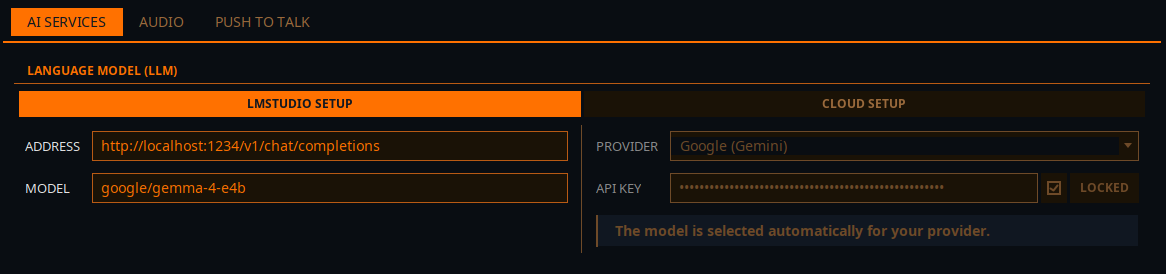
El lado izquierdo del panel, LMSTudio:
| Campo | Valor |
|---|---|
| Dirección | http://localhost:1234/v1/chat/completions. Si LM Studio corre en otro PC de tu red, pon la IP de ese PC en lugar de localhost |
| Modelo | google/gemma-4-e4b |
LM Studio es el único servidor de inferencia local que admite Elite Intel, y google/gemma-4-e4b
es el único modelo local admitido.
Requisitos de GPU
El hardware que necesitas para ejecutar el juego y el LLM en la misma máquina:
- RTX 3090 24 GB de VRAM
- AMD RX 7800 XT
La VRAM importa más que la velocidad de la GPU. Una tarjeta con solo 12 GB de VRAM no basta, por nueva que sea. Si tienes un segundo PC con una GPU potente, ejecuta LM Studio allí y apunta Elite Intel a él. Así el PC del juego no hace ningún trabajo de inferencia.
Hay una tabla de referencia de GPU elaborada por Kevin Rank aquí: Guía de referencia de GPU
Guías de instalación
| Guía | |
|---|---|
| LM Studio - Linux | Instalación de escritorio y cómo ejecutarlo como servidor |
| LM Studio - Windows | Aplicación de escritorio con interfaz gráfica |
| LLMs en la serie AMD RX | Configuración específica para AMD |
| LM Studio en Ubuntu Server | Instalación headless en una máquina dedicada a la inferencia |
¿Por qué precisamente google/gemma-4-e4b?
Elite Intel es un intérprete de órdenes y una herramienta de análisis de datos, no un chatbot de conversación. No basta con charlar de forma natural. El modelo tiene que deducir la acción correcta a partir de lo que dices, analizar los datos del juego y devolver resultados estructurados en lugar de una redacción o HTML. No todos los modelos de este tamaño lo hacen de forma fiable.
El requisito imprescindible es el function calling (llamada a funciones). El companion de Elite
Intel no le pide al modelo que describa lo que haría. Le da un conjunto de herramientas y espera
que llame a una, con argumentos. Un modelo que no sabe generar una llamada a herramienta bien
formada no puede manejar la aplicación en absoluto, por bien que escriba. google/gemma-4-e4b
admite function calling.
Con unos 6,3 GB cabe en la VRAM junto al juego en una tarjeta de 24 GB con margen de sobra. No se descarga nada a la CPU, así que las respuestas siguen siendo rápidas.
Sobre el modelo retirado de la V1.0. Las versiones anteriores recomendaban
tulu-3.1-8b-supernova. No admite function calling, así que no puede hacer funcionar el companion y ya no sirve con Elite Intel. Si sigues una guía antigua, ignórala e instalagoogle/gemma-4-e4b.
Opción 2: Nube
El lado derecho del panel, Configuración en la nube:
- Elige tu proveedor en la lista Proveedor.
- Pega la clave de ese proveedor en Clave API.
- Marca Bloqueado para que la clave guardada no se edite por accidente.
- Pulsa Guardar y luego inicia o reinicia los servicios en la pestaña Vega.
El proveedor lo eliges tú. Elite Intel no intenta adivinarlo a partir de la clave, porque los proveedores cambian el formato de sus claves con demasiada frecuencia como para que eso sea fiable. El modelo no lo eliges: Elite Intel escoge el adecuado para tu proveedor.
| Proveedor | Notas |
|---|---|
| Anthropic (Claude) | De pago |
| OpenAI | De pago |
| Google (Gemini) | De pago |
| xAI (Grok) | De pago |
| DeepSeek | De pago |
Cómo conseguir una clave de cada proveedor: Configurar un LLM en la nube.
¿Cuál debería usar?
Ejecuta LM Studio en local si:
- tienes una RTX 3090 24 GB o equivalente, o un segundo PC en tu red que la tenga
- quieres que todo se quede en tu propio hardware
Usa un proveedor en la nube si:
- tu GPU no tiene VRAM suficiente para ejecutar un modelo junto al juego
- prefieres no tener ningún servidor de inferencia
¿No lo tienes claro? Puedes empezar con cualquiera de las dos opciones y cambiar cuando quieras sin reinstalar nada.
Community 👉Matrix👈