Выбор локального сервера инференции
Для запуска локального LLM с Elite Intel необходим сервер инференции. Это программное обеспечение, которое загружает модель ИИ и предоставляет к ней доступ через локальный API. Это локальный эквивалент облачного сервиса ИИ, работающий полностью на твоём собственном железе.
Elite Intel использует LM Studio в качестве сервера инференции. Он работает в Windows и Linux и предоставляет OpenAI-совместимый API.
Требования к GPU
Требования к железу для запуска игры и LLM на одной машине:
- RTX 3090 24 ГБ VRAM
- AMD RX 7800 XT
Если железа недостаточно, воспользуйся бесплатным облачным сервисом на 👉 console.mistral.ai 👈 — бесплатный тариф, без банковской карты. Шаги настройки: Бесплатный облачный LLM.
Таблица сравнения GPU от Kevin Rank доступна здесь: Справочник по GPU
Руководства по установке
| Сервер инференции | |
|---|---|
| ✅ LM Studio - Linux | Быстрый, больше гибкости с моделями - руководство показывает настройку как сервера |
| ✅ LM Studio - Windows | Быстрый, больше гибкости с моделями - есть графический интерфейс |
| 🆓 Бесплатный облачный LLM | GPU не нужен - бесплатный тариф Mistral, без банковской карты |
LM Studio: кратко
| LM Studio | |
|---|---|
| Требуемая модель | google/gemma-4-e4b |
| Установка | Один скрипт, и готово |
| Запускается как | Ручной запуск или опциональный автозапуск |
| Настройка модели | Флаги при загрузке |
| Автозапуск в Windows | Нужно приложение или Планировщик заданий |
| Автозапуск в Linux | Ручная настройка systemd (см. руководство для Linux) |
| Источник моделей | HuggingFace (GGUF) |
| Порт API | 1234 |
| Графический интерфейс | Опциональное настольное приложение |
Руководство по выбору
Запускай LM Studio локально, если:
- У тебя есть NVIDIA RTX 3090 24 ГБ или аналог либо лучше. VRAM - критический фактор, а не скорость GPU. GPU с 12 ГБ VRAM недостаточно вне зависимости от поколения.
- Ты запускаешь Elite Dangerous и LLM на одной машине
- Хочешь направить Elite Intel на отдельный ПК в своей сети
- Тебе нужен графический интерфейс для просмотра, загрузки и управления моделями или чистый headless-сервер на выделенной машине
Лучше воспользуйся бесплатным облачным LLM, если:
- Твоей видеокарте не хватает VRAM, чтобы держать модель вместе с игрой
- Ты вообще не хочешь обслуживать локальный сервер инференции
Рекомендация разработчика
Разработчик использует LM Studio с google/gemma-4-e4b (~6,3 ГБ). Другие модели могут работать,
но это не гарантируется. Сообщайте о результатах совместимости в Matrix.
Почему именно google/gemma-4-e4b?
Elite Intel — это парсер команд и инструмент анализа данных, а не разговорный чат-бот. Это предъявляет к модели конкретные требования. Умения вести естественную беседу недостаточно. Модель должна правильно выводить действия из голосового ввода, выполнять структурированный анализ данных и возвращать результаты в виде структурированных данных, а не эссе в markdown или HTML. Не все модели такого размера делают это надёжно.
Жёсткое требование — вызов функций (function calling). Компаньон Elite Intel не просит модель
описать, что она сделала бы: он предлагает ей набор инструментов и ожидает вызова одного из них с
аргументами. Модель, которая не умеет формировать корректный вызов инструмента, вообще не сможет
управлять приложением, как бы хорошо она ни писала. google/gemma-4-e4b это поддерживает.
При объёме около 6,3 ГБ она помещается в VRAM рядом с игрой на карте с 24 ГБ с запасом, что исключает выгрузку на CPU и сохраняет высокую скорость инференса.
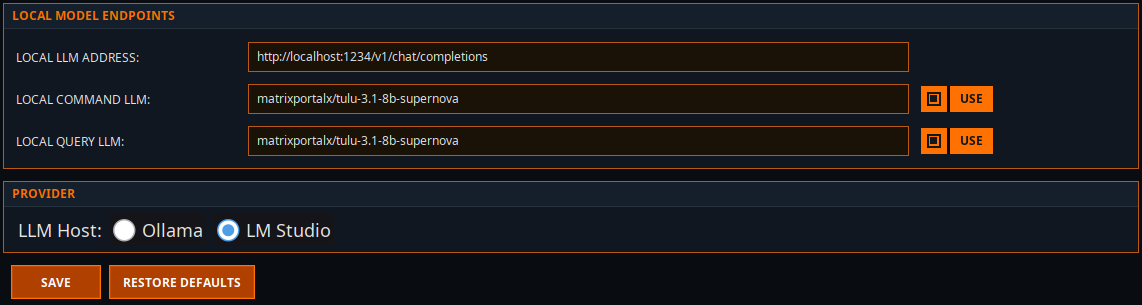
О снятой с поддержки модели V1.0. Ранние версии рекомендовали
tulu-3.1-8b-supernova. Она не поддерживает вызов функций, поэтому не может работать с компаньоном и больше не пригодна для Elite Intel. Если вы следуете старому руководству, не используйте его и установитеgoogle/gemma-4-e4b.
Можно ли использовать другую модель?
Можно использовать альтернативные модели, но они должны поддерживать вызов функций. Без этого приложение не сможет ничего выполнить.
Чаще всего с альтернативной моделью происходит сбой формата ответа: модель возвращает текст с описанием действия вместо фактического вызова инструмента.
Community 👉Matrix👈