Choisir votre LLM
Elite Intel a besoin d'un modèle de langage (LLM) pour comprendre vos commandes et répondre à vos questions. Il y a deux façons d'en obtenir un, et les deux se configurent dans Paramètres → Services IA → Modèle de langage (LLM) :
| Option | Ce qu'il vous faut | Coût |
|---|---|---|
| Local : LM Studio | Un GPU puissant, LM Studio et le modèle google/gemma-4-e4b |
Gratuit. Tout reste sur votre PC |
| Cloud | Un compte et une clé API chez un fournisseur pris en charge | Le fournisseur facture votre consommation |
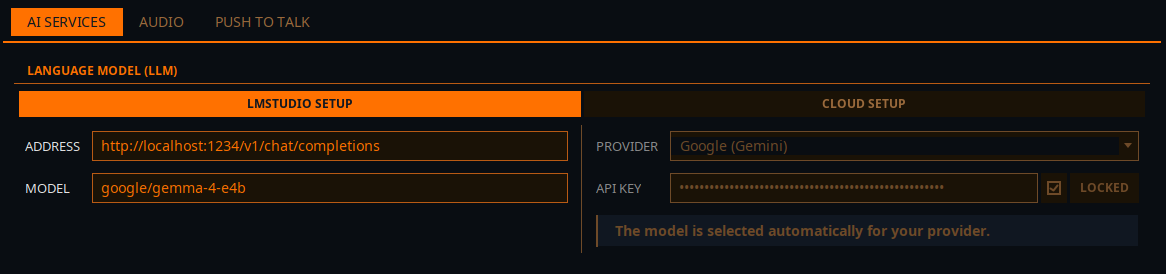
Option 1 : local (LM Studio)
La partie gauche du panneau, LMStudio :
| Champ | Valeur |
|---|---|
| Adresse | http://localhost:1234/v1/chat/completions. Si LM Studio tourne sur un autre PC de votre réseau, remplacez localhost par l'adresse IP de ce PC |
| Modèle | google/gemma-4-e4b |
LM Studio est le seul serveur d'inférence local pris en charge par Elite Intel, et
google/gemma-4-e4b le seul modèle local pris en charge.
Exigences GPU
Le matériel nécessaire pour faire tourner le jeu et le LLM sur la même machine :
- RTX 3090 24 Go VRAM
- AMD RX 7800 XT
La VRAM compte plus que la vitesse du GPU. Une carte avec seulement 12 Go de VRAM ne suffit pas, aussi récente soit-elle. Si vous avez un second PC équipé d'un GPU puissant, faites-y tourner LM Studio et pointez Elite Intel dessus. Le PC de jeu n'a alors aucun travail d'inférence à faire.
Un tableau de référence des GPU réalisé par Kevin Rank est disponible ici : Guide de référence GPU
Guides d'installation
| Guide | |
|---|---|
| LM Studio - Linux | Installation de bureau, et comment le faire tourner en serveur |
| LM Studio - Windows | Application de bureau avec interface graphique |
| LLM sur la série AMD RX | Configuration propre à AMD |
| LM Studio sur Ubuntu Server | Installation headless sur une machine d'inférence dédiée |
Pourquoi google/gemma-4-e4b précisément ?
Elite Intel est un analyseur de commandes et un outil d'analyse de données, pas un chatbot de conversation. Savoir bavarder de façon naturelle ne suffit pas. Le modèle doit déduire la bonne action de ce que vous dites, analyser les données du jeu et renvoyer des résultats structurés plutôt qu'une dissertation ou du HTML. Tous les modèles de cette taille n'y arrivent pas de façon fiable.
L'exigence incontournable est le function calling (appel de fonctions). Le companion d'Elite
Intel ne demande pas au modèle de décrire ce qu'il ferait. Il lui donne un ensemble d'outils et
attend qu'il en appelle un, avec des arguments. Un modèle incapable de produire un appel d'outil
bien formé ne peut pas piloter l'application du tout, aussi bien qu'il écrive.
google/gemma-4-e4b prend en charge le function calling.
Avec environ 6,3 Go, il tient dans la VRAM à côté du jeu sur une carte de 24 Go, avec de la marge. Rien n'est déporté sur le CPU, donc les réponses restent rapides.
À propos du modèle retiré de la V1.0. Les versions précédentes recommandaient
tulu-3.1-8b-supernova. Il ne prend pas en charge le function calling, ne peut donc pas faire tourner le companion et ne fonctionne plus avec Elite Intel. Si vous suivez un ancien guide, ignorez-le et installezgoogle/gemma-4-e4b.
Option 2 : cloud
La partie droite du panneau, Configuration cloud :
- Choisissez votre fournisseur dans la liste Fournisseur.
- Collez la clé de ce fournisseur dans Clé API.
- Cochez Verrouillé pour que la clé enregistrée ne puisse pas être modifiée par accident.
- Cliquez sur Enregistrer, puis démarrez ou redémarrez les services dans l'onglet Vega.
C'est vous qui choisissez le fournisseur. Elite Intel n'essaie pas de le deviner à partir de la clé, car les fournisseurs changent trop souvent le format de leurs clés pour que ce soit fiable. Vous ne choisissez pas de modèle : Elite Intel prend celui qui convient à votre fournisseur.
| Fournisseur | Remarques |
|---|---|
| Anthropic (Claude) | Payant |
| OpenAI | Payant |
| Google (Gemini) | Payant |
| xAI (Grok) | Payant |
| DeepSeek | Payant |
Comment obtenir une clé chez chaque fournisseur : Configurer un LLM cloud.
Lequel choisir ?
Faites tourner LM Studio en local si :
- vous avez une RTX 3090 24 Go ou équivalent, ou un second PC sur votre réseau qui en a une
- vous voulez que tout reste sur votre propre matériel
Utilisez un fournisseur cloud si :
- votre GPU n'a pas assez de VRAM pour faire tourner un modèle à côté du jeu
- vous préférez ne pas gérer de serveur d'inférence du tout
Vous hésitez ? Vous pouvez commencer par l'une ou l'autre option et en changer à tout moment sans réinstaller.
Community 👉Matrix👈