Вкладка «Статистика»
 Во что вам обходится
языковая модель — в токенах и в задержке.
Токен — базовая единица вычислений языковой модели, примерно слово или число. Если вы пользуетесь платным облачным провайдером, токены и есть счётчик.
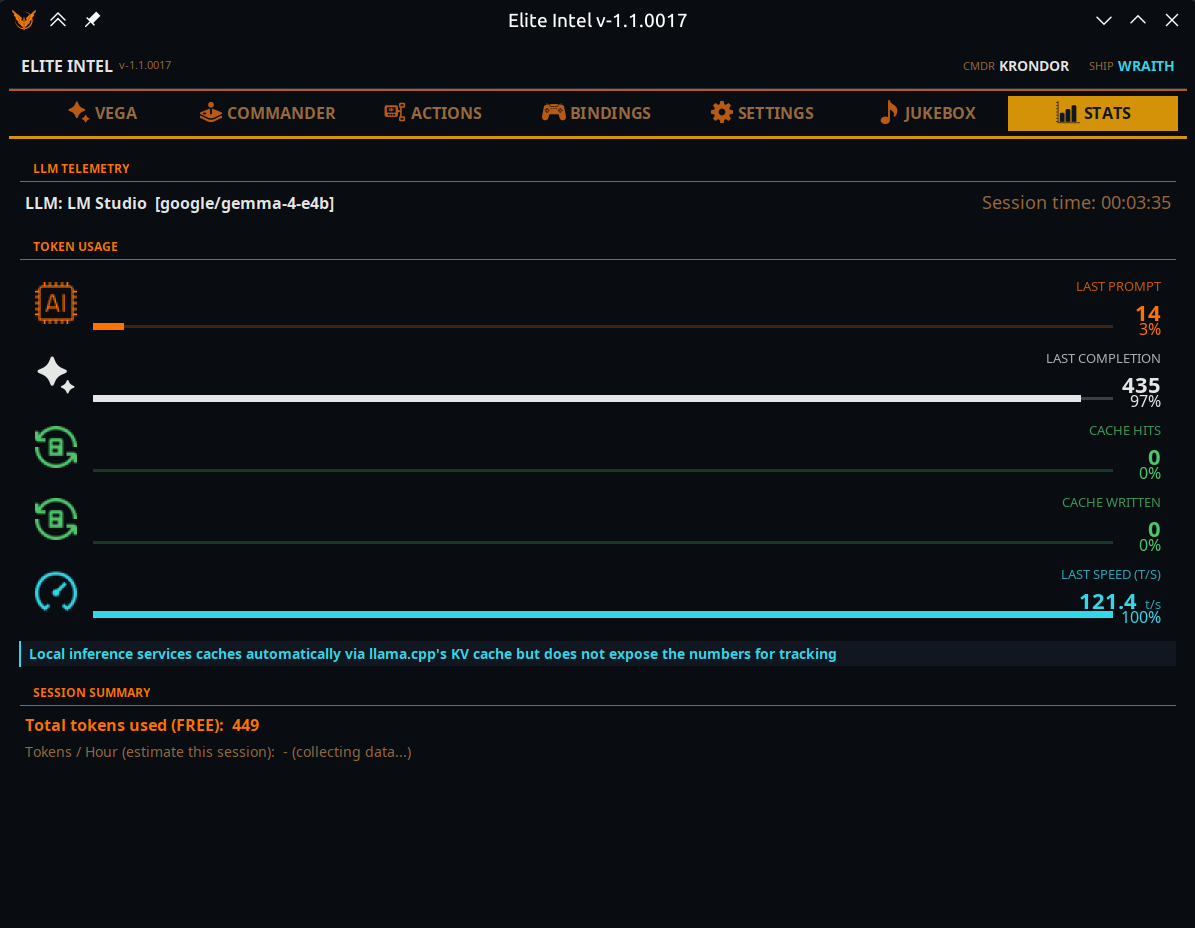
Телеметрия LLM
Модель, которая на самом деле обслуживает ваши запросы, и сколько времени идёт текущая сессия. Имя модели — это то, что ответило, а не то, что вы настроили, поэтому именно здесь вы убеждаетесь, что смена провайдера действительно сработала.
Расход токенов
Пять полос. Они описывают последний запрос, а не сессию, чтобы вы видели форму одного обмена.
| Поле | Значение |
|---|---|
| Последний запрос | Отправленные входные токены |
| Последний ответ | Сгенерированные выходные токены |
| Попадания в кэш | Ввод, обслуженный из кэша вместо повторной тарификации |
| Записано в кэш | Ввод, записанный в кэш, чтобы последующие запросы в него попадали |
| Последняя скорость | Токенов в секунду |
Четыре токенные полосы заполняются как доля от общего объёма этого одного запроса, поэтому читаются как состав. У скорости нет фиксированного потолка, поэтому её полоса заполняется относительно самого быстрого ответа за сессию.
Сводка сессии
| Строка | Значение |
|---|---|
| Токенов использовано | Помечено (БЕСПЛАТНО) для локальной модели и (платно) для облачной |
| Токенов сэкономлено кэшем | Только облако. Как только появляются попадания, показывает «обслужено по сниженному тарифу» |
| Токенов / час | Прогноз. Первые 10 минут показывает «сбор данных…», потому что скорость, экстраполированная из двух минут игры, — это выдумка |
Что цифры значат на практике
Типичная сессия в сумме идёт примерно по 250 000 токенов в час.
Облачная интеграция Elite Intel настроена под каждого провайдера на максимальное кэширование промптов, а закэшированные токены либо бесплатны, либо тарифицируются по сниженной ставке. Какая доля из этих 250 000 попадёт в кэш, целиком зависит от провайдера: одни кэшируют до 80 %, другие ближе к 40 %. Именно эта разница в основном и отделяет дешёвого провайдера от дорогого, и её стоит понаблюдать здесь в течение сессии, прежде чем на чём-то остановиться.
У локальной модели показателей кэша нет. Локальный инференс кэширует — llama.cpp держит KV-кэш и использует его, — но не сообщает цифры, поэтому честно показать нечего. Панель так и пишет, вместо того чтобы выводить вводящий в заблуждение ноль, и полностью скрывает строку кэша.
Живую сводную версию тех же данных несёт вкладка «Вега»: внизу у неё полоса Сводка системы из шести блоков.
Community 👉Matrix👈